英伟达 DGX Spark 支持 8 台集群:128GB 版本统一内存最高达 1TB,RTX PRO 6000 Blackwell 相关任务提速 40% - 平台使用指南
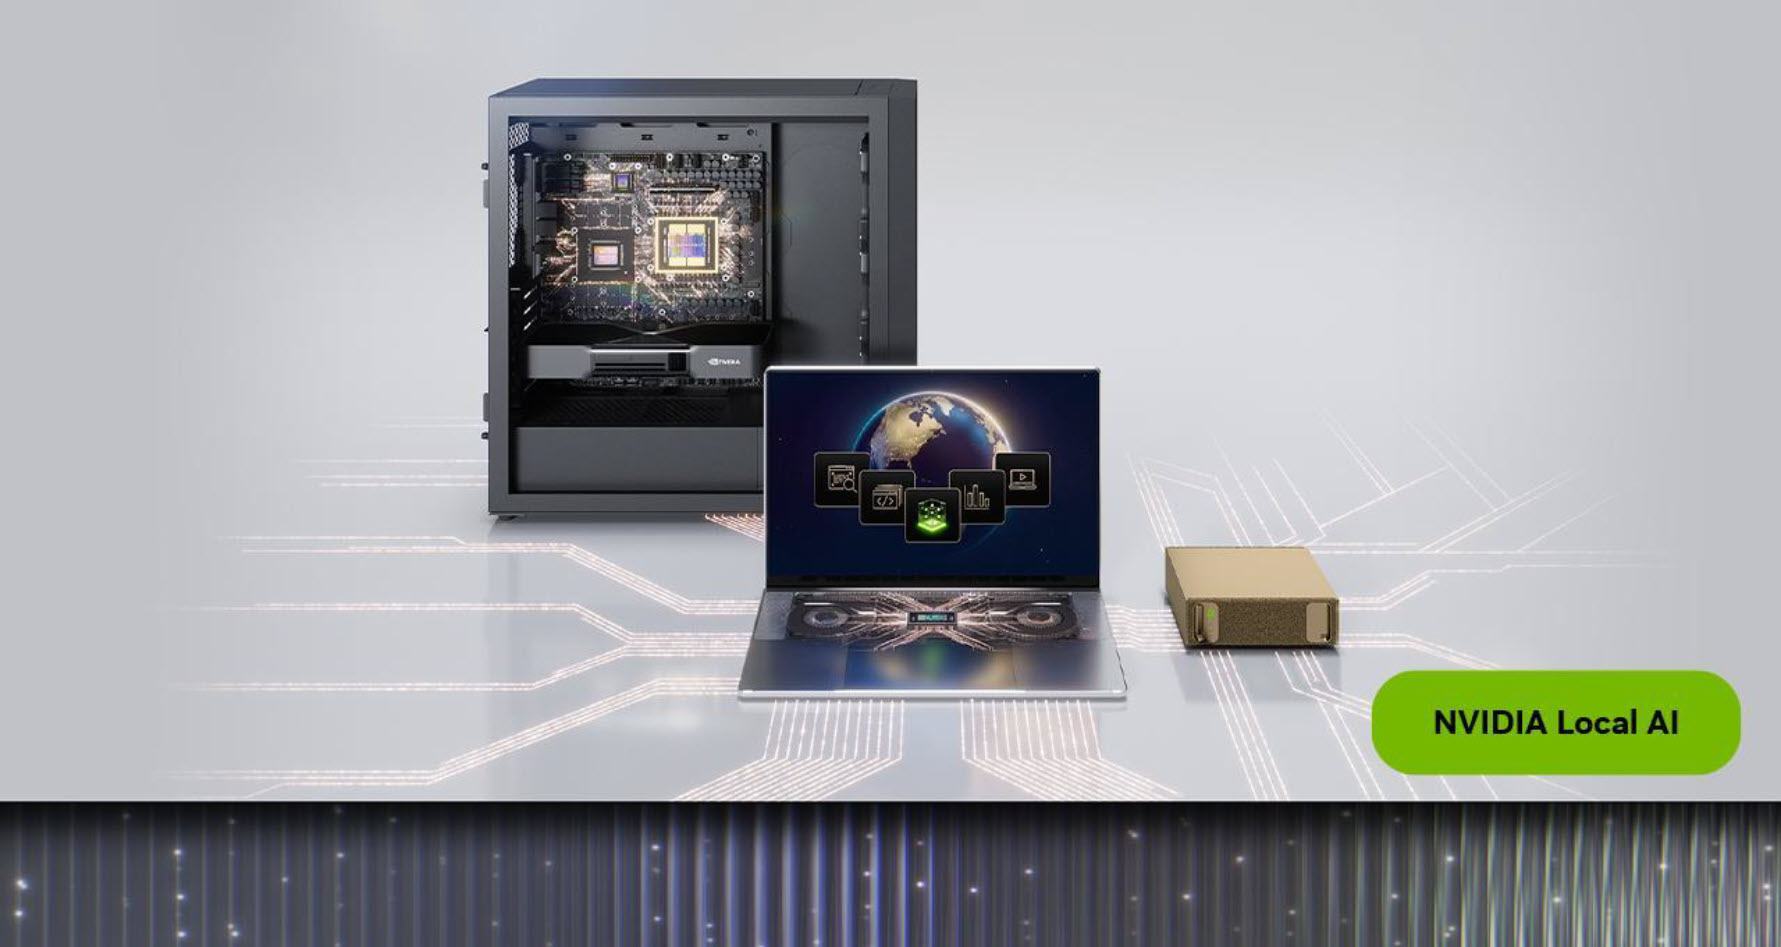
英伟达在柏林 GTC 2026 大会上透露,DGX Spark 先前仅支持最多四台设备构建集群,现在已开放手动配置,最多能实现八台设备联合运行。若采用 128GB 版本,这些设备的总统一内存容量最高可达到 1TB。
与此同时,英伟达推出了本地 AI 平台的升级,并宣布与 llama.cpp 和 vLLM 开源社区携手,以增强 AI 推理效率。在特定工作负载下,RTX PRO 6000 Blackwell 的推理性能可提升最多 40%,而 DGX Spark 和 DGX Station 分别获得了最高 30% 和 20% 的性能增长。
英伟达指出,定价 4,999 美元(按当前汇率约合 33,450 元人民币)的 DGX Spark 64GB 版本将于 10 月 23 日起通过合作伙伴逐步上市。针对集群部署,英伟达 Sync Model Launcher 计划在本月晚些时候推出,用户可借此工具下载与硬件配置匹配的模型和容器,并将模型连接到 OpenCode。此工具还会自动加载 DGX Spark Skills,为设备故障排查、维护及工作流程提供指引。
在软件更新方面,10 月版的 DGX Spark 更新新增了 Wi-Fi 助手功能,允许设备在 appliance mode 下切换无线网络。DGX Spark Skills 也将通过 OpenCode 集成到英伟达 Sync 中,为日常维护和故障排查提供支持。
模型方面,英伟达宣布支持更多可在本地运行的 AI 模型,包括 Nemotron、GLM、DeepSeek、Qwen、MiniMax 和 FLUX.3 Klein 等,这些模型覆盖了智能体、编程、图像生成和编辑等任务。
此外,英伟达推出了针对本地 AI 硬件优化的 Recursive Flint 编程模型。该模型采用混合专家(MoE)架构,总参数量为 400 亿,激活参数量为 25 亿。英伟达称,在配备 64GB 内存的 RTX Spark 上,该模型的推理速度超过每秒 220 个词元。
为应对本地运行大型模型时的内存压力,英伟达发布了一组优化内存使用的模型检查点,通过量化降低内存占用,同时尽量保持接近全精度模型的准确性。其中,Qwen3.8-Flash-Next-FP4-Local 可在单台 128GB DGX Spark 或 RTX PRO 6000 上运行;GLM-5.3-Flash-FP4-Local 则面向两台系统的配置。
推理性能优化是此次更新的另一个重点。根据英伟达公布的数据,在 llama.cpp 中,针对 Qwen 3.8 Flash Next 的多 token 预测(MTP)推测解码优化,可使 RTX PRO 6000 Blackwell 上的端到端智能体任务提速最高 1.4 倍;在 vLLM 中,针对 Qwen3.8 27B 的推测解码和 FlashInfer 预填充内核优化,可使 DGX Spark 上的相关任务提速最高 1.3 倍;DGX Station 运行 GLM 5.3 Flash 时,吞吐量最高提升至原来的 1.2 倍。
英伟达还公布了 DGX Station 的企业管理与应用扩展计划,包括新增 Absolute Security、思科旗下 Splunk、Microsoft Intune、Tanium 等七项管理集成,以帮助企业部署和管理本地 AI 基础设施。
DGX Station 的 Windows 版本预计于 12 月推出,将支持制造业相关应用,以及设计、仿真、验证和工程自动化工作流。
此外,英伟达计划为 DGX Station 推出开放源代码机器人参考工作流,并以早期访问形式提供 NVIDIA Cloud Functions,让团队通过统一接口共享本地模型服务。

